Migrar un sistema sin cortar el servicio
Los patrones que usamos para sustituir sistemas en producción que no se pueden parar: estrangulamiento progresivo, tráfico en sombra, sincronización de datos y vuelta atrás en minutos.
En banca, seguros o automoción no existe un “este fin de semana paramos el sistema para migrarlo”. Hay miles de usuarios, procesos de terceros enganchados y operaciones a cualquier hora. Después de muchos años migrando plataformas en esas condiciones, estos son los patrones a los que siempre volvemos.
La idea de fondo: nunca un gran salto
Las migraciones que salen mal suelen tener algo en común: un día D en el que se apaga lo viejo y se enciende lo nuevo. Si algo falla, falla todo a la vez y delante de todos.
La alternativa es migrar por trozos pequeños, reversibles y medibles. Es más lento sobre el papel, pero en la práctica termina antes, porque no hay que deshacer desastres.
Entender el sistema y repartir el tráfico
Primero, observar el sistema actual
Antes de tocar nada, medimos el sistema viejo: latencias, volúmenes, errores y picos. Sin esa línea base, después no hay forma de saber si el sistema nuevo es mejor, peor o igual.
A menudo esta fase descubre cosas que nadie había documentado: un proceso nocturno del que depende contabilidad, un cliente que llama a un endpoint que se creía muerto, un fichero que alguien recoge por FTP cada lunes.
Estrangular, no sustituir
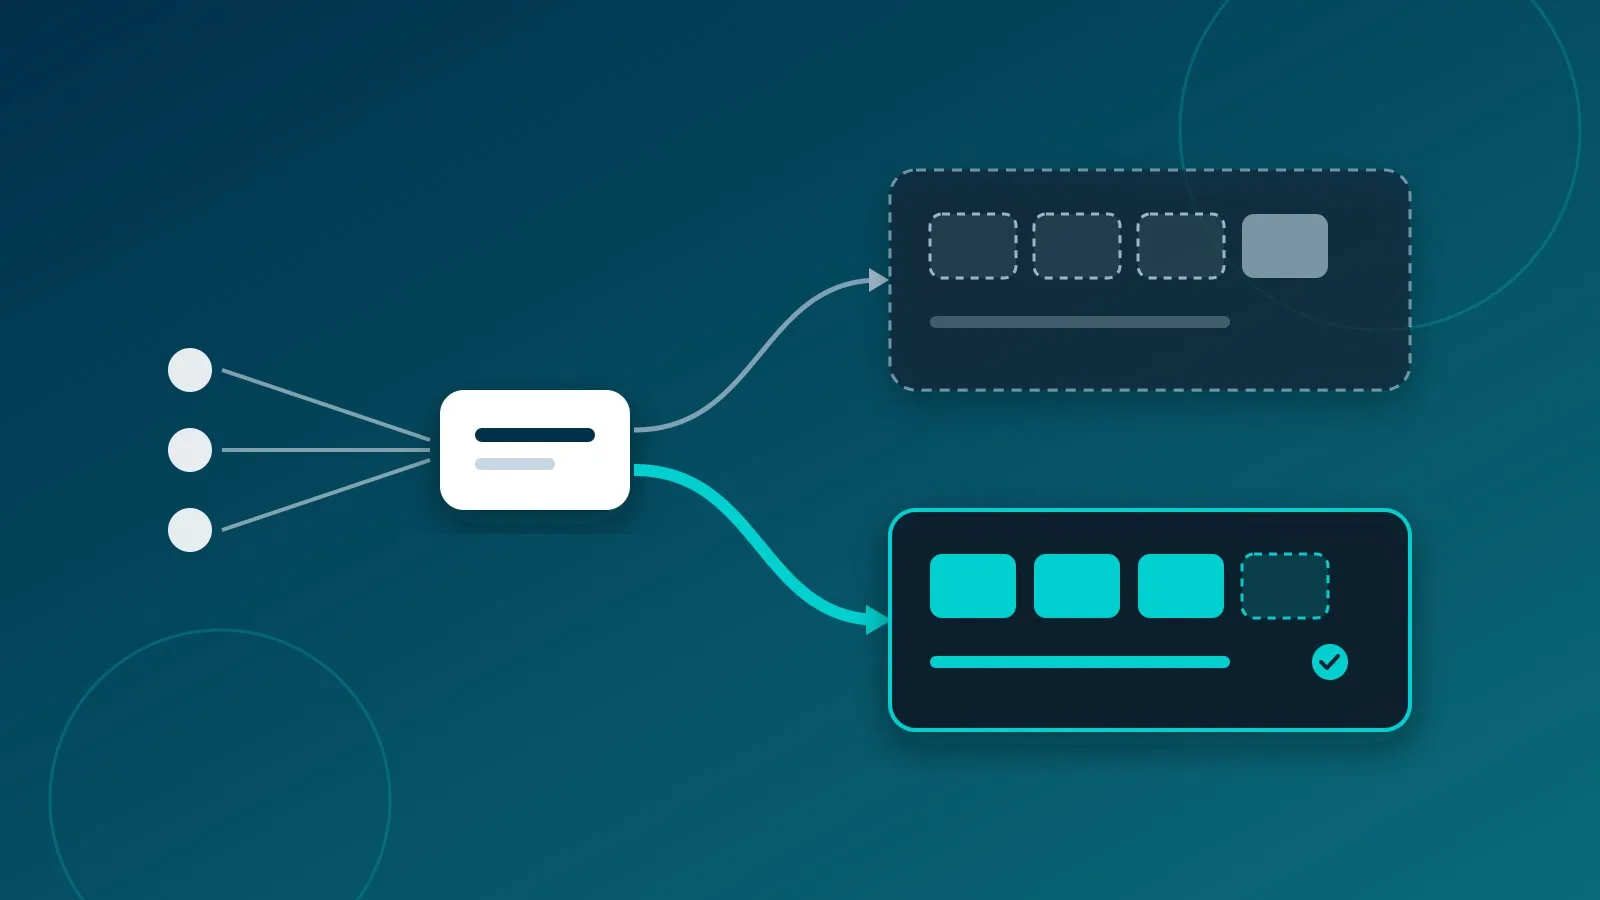
El patrón strangler fig (higuera estranguladora) consiste en poner una capa delante del sistema viejo, como un proxy o un balanceador, que decide a dónde va cada petición.
Al principio todo va al sistema viejo. Luego se migra una funcionalidad concreta y esa capa empieza a enviarla al sistema nuevo. Funcionalidad a funcionalidad, el sistema viejo se va quedando sin trabajo hasta que se puede apagar sin que nadie lo note.
Tráfico en sombra antes que tráfico real
Antes de que el sistema nuevo responda a usuarios reales, le enviamos una copia del tráfico real y comparamos sus respuestas con las del viejo, sin que el usuario vea nada del nuevo.
Ojo con los efectos: el sistema nuevo en sombra no puede enviar correos, cobrar ni escribir en sistemas de terceros; solo calcula y compara.
Con nginx, por ejemplo, se hace con el módulo mirror (con los upstream viejo y nuevo ya definidos):
location /api/ {
    proxy_pass http://viejo;              # responde al usuario
    mirror /sombra;                       # copia silenciosa al sistema nuevo
    mirror_request_body on;
}

location = /sombra {
    internal;
    proxy_pass http://nuevo$request_uri;  # su respuesta se descarta
}
nginx solo copia la petición y descarta la respuesta: comparar ambas respuestas lo haces con tus logs o con una herramienta de diff.
Las diferencias son oro. Algunas son errores del sistema nuevo, otras son errores históricos del viejo que hay que decidir si se mantienen por compatibilidad. Mejor descubrirlas aquí que en una reclamación.
Los datos son la parte difícil
Mover código es fácil comparado con mover datos que no paran de cambiar. Nuestro orden habitual:
- Carga inicial de los datos históricos al sistema nuevo.
- Sincronización continua de los cambios que se producen mientras tanto (captura de cambios, o CDC, sobre la base de datos de origen).
- Conciliación automática: un proceso que compara ambos lados y alerta de cualquier diferencia.
- Cambio de dueño: el sistema nuevo pasa a ser el que escribe, y el viejo queda en solo lectura una temporada.
El paso 3 es el que más se salta y el que más disgustos ahorra.
Y ojo con la vuelta atrás: una vez que el sistema nuevo escribe, volver al viejo exige sincronizar en sentido inverso, así que ese camino también se prueba antes del cambio.
Activar y desplegar con vuelta atrás
Interruptores, no despliegues
Que el código esté desplegado no significa que esté activo. Con feature flags (interruptores por funcionalidad o por cliente) activamos lo nuevo primero para un cliente interno, luego para un pequeño porcentaje y después para todos.
Si algo va mal, se apaga el interruptor. Volver atrás tarda segundos, no un despliegue de emergencia.
Despliegue azul/verde y canario
Para la infraestructura usamos la misma lógica. Con un despliegue azul/verde la versión nueva arranca al lado de la actual y el balanceador cambia el tráfico de una a otra. En un despliegue canario se manda primero una fracción pequeña del tráfico y se vigilan las métricas antes de seguir.
Con nginx, un canario sencillo es repartir por cliente con split_clients (con los upstream actual y nueva definidos):
# El 5 % de los clientes, por IP, va a la versión nueva.
split_clients "${remote_addr}" $version {
    5%  nueva;
    *   actual;
}

location / {
    proxy_pass http://$version;
}
Subir el porcentaje es cambiar el 5 % y recargar la configuración. Volver atrás es quitar esa línea y recargar. En un sistema real conviene repartir por identificador de usuario, no por IP, para que cada persona vea siempre la misma versión.
En ambos casos, la versión anterior sigue viva hasta que estamos seguros. La vuelta atrás tiene que estar probada antes de necesitarla.
Comunicar y comprobar
Comunicar como parte del plan
Los equipos que usan el sistema deben saber qué va a cambiar, cuándo y a quién avisar si notan algo raro. Muchas incidencias de una migración no son técnicas: son un usuario que encuentra un botón en otro sitio un lunes por la mañana.
Una lista para tu próxima migración
- ¿Tienes métricas del sistema actual para comparar?
- ¿Puedes migrar una sola funcionalidad sin migrar el resto?
- ¿Puedes probar el sistema nuevo con tráfico real sin afectar a nadie?
- ¿Sabes en todo momento si los datos de ambos lados coinciden?
- ¿Cuánto tardas en volver atrás? ¿Lo has probado?
Si alguna respuesta es “no”, ahí está el riesgo.
Lo esencial
- Migrar por trozos pequeños, reversibles y medibles, nunca de un gran salto.
- Medir antes, probar en sombra y comprobar que los datos de ambos lados coinciden.
- Tener siempre la vuelta atrás probada antes de necesitarla.
Si tienes un sistema heredado que se ha quedado corto pero que no te puedes permitir parar, hablemos. Es justo el tipo de proyecto que más nos gusta. Y si vas a construir el sistema nuevo, te contamos cómo elegimos el backend en cada proyecto.
Artículos relacionados
Django o Supabase: por qué nuestro ERP y nuestras apps usan stacks distintos
Almeebar usa Django REST y PostgreSQL; BIT Project, BIT Talents y nuestro GMAO usan React y Supabase. Los criterios con los que elegimos backend en cada proyecto.